สมมติ AI ช่วยทำฟีเจอร์แจ้งเตือนงานเกินกำหนดเสร็จแล้ว แต่ก่อนปล่อยให้ลูกค้าใช้ ทีมยังต้องตอบว่าใครตรวจสิทธิของผู้รับข้อความ จะรู้ได้อย่างไรว่าส่งไม่ซ้ำ และถ้าระบบผิดปกติใครเป็นคนหยุดงาน โค้ดที่เขียนเสร็จจึงยังต้องผ่านการตรวจ และต้องมีคนดูแลหลังเปิดใช้
Platform Engineering ช่วยจัดเครื่องมือและขั้นตอนที่ทีมต้องใช้ซ้ำในการทดสอบและปล่อยระบบ ให้คนในทีมใช้ร่วมกันได้ง่ายขึ้น เมื่อ AI ช่วยร่างโค้ดหรือการตั้งค่า เราก็ยังต้องตัดสินใจเรื่องขอบเขต สิทธิ หลักฐาน และคนดูแลระบบต่อ
บทความนี้ใช้ทีมซอฟต์แวร์และ SI สมมติเป็นตัวอย่าง เพื่อพิจารณาว่าควรลงทุนกับแพลตฟอร์มภายในเมื่อไร เริ่มเล็กแค่ไหน และวัดความคุ้มอย่างไร โดยไม่ตั้งต้นว่าทุกบริษัทต้องสร้างทีมใหม่หรือซื้อเครื่องมือชุดเดียวกัน
Platform Engineering เริ่มจากงานที่ผู้ใช้ต้องทำ
Platform Engineering คืองานออกแบบและดูแลเครื่องมือ ขั้นตอน และบริการที่ทีมภายในใช้ร่วมกัน เพื่อให้ผู้ใช้ทำงานได้เอง โดยรู้ว่าต้องทำตามกติกาใดและใครเป็นผู้ดูแล ผลงานอาจเป็นแม่แบบเริ่มโครงการ ขั้นตอนทดสอบและปล่อยระบบ บริการจัดเก็บข้อมูลลับ เอกสาร หรือช่องทางขอใช้ทรัพยากรที่เชื่อมกัน ไม่จำเป็นต้องเริ่มจากหน้าจอศูนย์กลาง
CNCF Platforms White Paper วางแพลตฟอร์มเป็นผลิตภัณฑ์สำหรับผู้ใช้ภายใน จึงควรเริ่มจากงานที่ผู้ใช้ติดขัดและรับฟังผลใช้งานต่อเนื่อง สำหรับทีมสมมติของเรา ผู้ใช้ต้องการเปิดโครงการใหม่แล้วรู้วิธีทดสอบและปล่อยงานได้ โดยไม่ต้องถามคนเดิมซ้ำทุกครั้ง การรู้ว่าจะช่วยงานใดทำให้ทีมเลือกได้ว่าจะสร้างอะไรก่อน
DevOps เน้นวิธีทำงานร่วมกันระหว่างการพัฒนาและการดูแลระบบ ส่วน SRE ใช้วิศวกรรมจัดการความน่าเชื่อถือของบริการ เช่น การติดตามสถานะและรับมือเหตุขัดข้อง ทีมอาจใช้เครื่องมือและขั้นตอนของแพลตฟอร์มช่วยงานเหล่านี้ได้ โดยยังต้องมีผู้รับผิดชอบแต่ละบริการ อ่านความสัมพันธ์ของ DevOps กับ SRE ได้จาก บทนำหนังสือ Site Reliability Engineering ของ Google โดยไม่จำเป็นต้องนำโครงสร้างทีมของ Google มาใช้ทั้งชุด
Developer portal เป็นทางเข้าหนึ่งของแพลตฟอร์ม เช่น Backstage ซึ่งเป็น framework สำหรับสร้าง developer portal แต่การมีรายชื่อบริการและปุ่ม deploy ยังไม่ยืนยันว่าทดสอบผ่าน กำหนดสิทธิถูก หรือมีคนรับเหตุขัดข้อง ต้องตรวจด้วยว่าระบบที่ปุ่มเหล่านั้นเรียกใช้ทำงานได้ตามที่ต้องการหรือไม่
AI เปลี่ยนงานส่วนไหน และอะไรยังต้องตัดสินใจ
หน้า Platform Engineering ของ DORA เชื่อมข้อค้นพบปี 2025 กับมุมมองว่า AI อาจขยายทั้งจุดแข็งและจุดติดขัดเดิมขององค์กร จึงควรดูด้วยว่าการทดสอบ ตรวจ และปล่อยใช้เร็วขึ้นตามการเขียนโค้ดหรือไม่ หน้านี้ยังอ้างงานวิจัยปี 2024 ที่กล่าวถึงประโยชน์และข้อจำกัดด้านการส่งงานและเสถียรภาพของระบบ ข้อค้นพบเหล่านี้ไม่ได้รับรองว่าการสร้างแพลตฟอร์มจะให้ผลเหมือนกันทุกทีม
ในทางออกแบบ AI ที่เสนอการเปลี่ยนแปลงผ่าน API หรือคำสั่งควรมีตัวตนที่ตรวจสอบได้ ใช้สิทธิเท่าที่จำเป็น และมีเพดานใช้ทรัพยากรตามงาน เช่น งบหรือเวลารัน การบอกใน prompt ว่าห้ามแตะระบบจริงอย่างเดียวไม่ใช่การบังคับสิทธิ ต้องมีกติกาที่ระบบด้านหลังตรวจจริง พร้อมหลักฐานว่าใครหรืออะไรขอทำงานใด
เอกสาร GitHub Copilot cloud agent เป็นตัวอย่างเฉพาะผลิตภัณฑ์ที่อธิบายขอบเขต branch การตรวจโดยคน และบันทึกการทำงาน การออกแบบของทีมอื่นต้องตรวจเครื่องมือกับการตั้งค่าที่ใช้อยู่เอง และจัดระดับการอนุมัติให้เหมาะกับผลกระทบ ไม่ทำให้การแก้เอกสารเล็กน้อยต้องผ่านขั้นตอนเท่าการเปลี่ยนสิทธิหรือโครงสร้างข้อมูลลูกค้า
อีกเรื่องที่ต้องแยกคือใช้ AI ช่วยสร้างแพลตฟอร์ม กับสร้างแพลตฟอร์มเพื่อให้บริการงาน AI ถ้าระบบต้องเรียกโมเดลหรือประมวลผลข้อมูลด้วยโมเดล อาจต้องเพิ่มการทดสอบคุณภาพคำตอบ สิทธิเข้าถึงข้อมูล และงบการเรียกใช้ แต่การเพิ่มผู้ช่วยเขียนโค้ดไม่ได้ทำให้ทุกทีมต้องมี GPU หรือระบบให้บริการโมเดลของตัวเอง
ลองดูว่าทีมต้องทำอะไร ก่อนและหลังเปิดใช้ฟีเจอร์
ลองกลับมาที่ฟีเจอร์แจ้งเตือนงานเกินกำหนด AI ช่วยร่างโค้ดและชุดทดสอบได้ ส่วนทีมกำหนดก่อนว่าผู้รับข้อความเป็นใคร ข้อมูลใดเปิดเผยได้ และเมื่อระบบลองทำงานซ้ำจะป้องกันการส่งข้อความเดิมซ้ำอย่างไร ประเด็นการทำซ้ำนี้ใช้กับงานที่อาจเกิดผลซ้ำ ไม่ได้หมายความว่าทุกคำสั่งมีวิธีแก้แบบเดียวกัน
แม่แบบของโครงการอาจเตรียมขั้นตอนตรวจโค้ดและทดสอบด้วยข้อมูลทดสอบไว้ให้แล้ว ผู้พัฒนาเพิ่มกรณีเฉพาะของฟีเจอร์เข้าไป ผลทดสอบควรบอกทีมได้ว่าตรวจอะไรแล้ว ส่วนใดยังไม่ตรวจ และใครรับผิดชอบข้อยกเว้น แทนการเห็นเพียงสถานะสีเขียวที่ไม่มีรายละเอียด
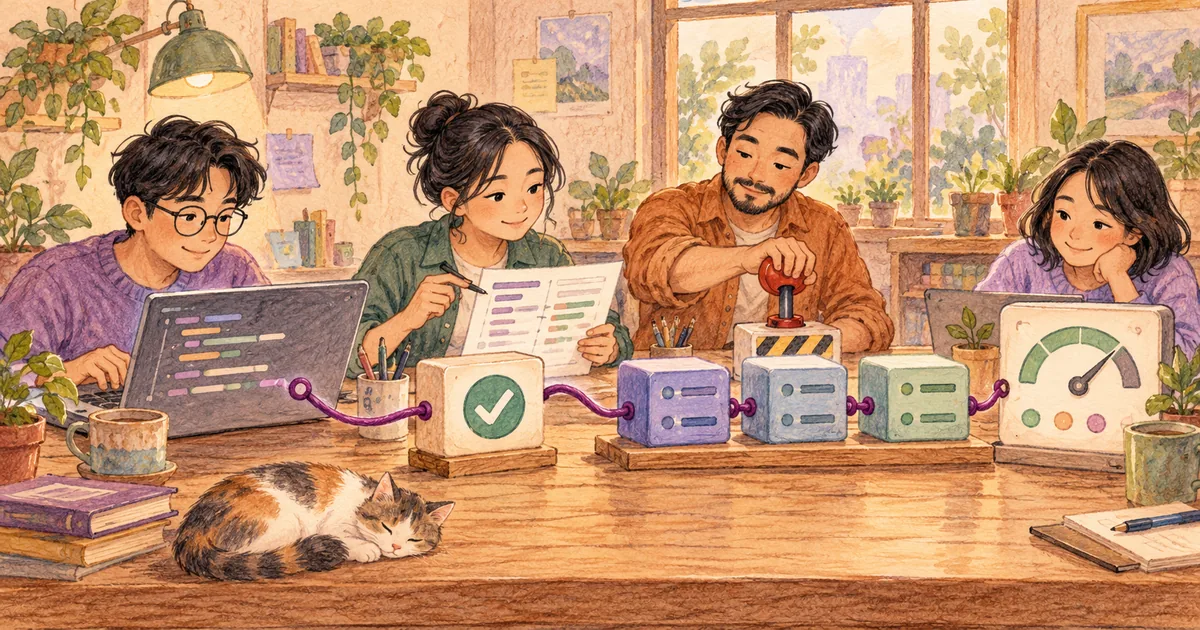
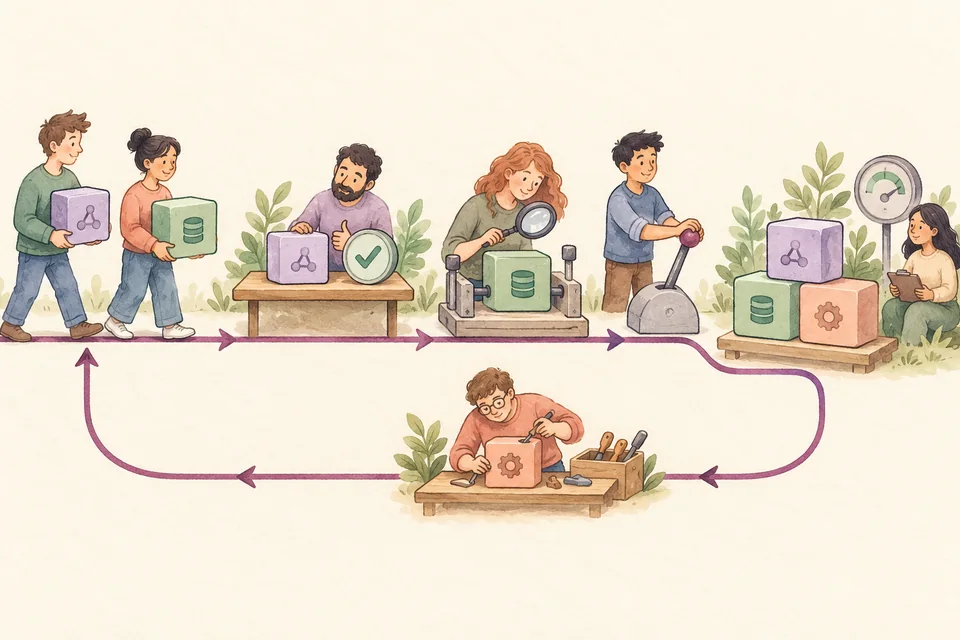
ตั้งแต่แก้โค้ดจนถึงดูแลระบบหลังเปิดใช้
- เสนอการเปลี่ยนแปลงคนหรือ AI ทำงานในขอบเขตสิทธิที่กำหนด
- ทดสอบและเก็บหลักฐานตรวจขั้นตอนที่ใช้ร่วมกันและกรณีเฉพาะของฟีเจอร์
- เลือกวิธีตรวจตามความเสี่ยงกำหนดวิธีตรวจและผู้ตรวจให้เหมาะกับความเสี่ยง
- ปล่อยใช้งานรู้ว่าเปิดใช้รุ่นใดกับส่วนไหน และหยุดได้อย่างไร
- ติดตามและรับมือตรวจพบปัญหาและรู้ว่าใครต้องเข้าไปแก้
ทีมใช้ผลทดสอบและปัญหาหลังเปิดใช้ มาปรับแม่แบบ กติกา และเอกสาร
ก่อนเปิดใช้ ทีมควรรู้ว่าจะดูสัญญาณใด เช่น งานส่งข้อความที่ล้มเหลวหรือการส่งซ้ำ และใครมีสิทธิหยุดงานนั้น การเปลี่ยนที่เสี่ยงอาจเริ่มในขอบเขตจำกัดตามแผนที่ทีมทดสอบไว้ การมีทางหยุดต้องมาพร้อมคนที่รู้ว่าเมื่อไรควรใช้
การกลับรุ่นโค้ดไม่ได้เรียกอีเมลที่ส่งไปแล้วคืน และไม่ได้ย้อนการเปลี่ยนข้อมูลทุกชนิดให้เอง งานที่แก้ฐานข้อมูลจึงต้องมีแผนตรวจและกู้ข้อมูลที่เหมาะกับการเปลี่ยนนั้นด้วย ทีมดูแลแพลตฟอร์มรับผิดชอบเครื่องมือ ขั้นตอน และบริการที่ใช้ร่วมกัน ส่วนเจ้าของฟีเจอร์ยังต้องเข้าใจพฤติกรรมของงานที่ปล่อย
เริ่มจากเครื่องมือที่ทีมใช้อยู่ แล้วกำหนดคนดูแล
ทีมสมมติอาจเริ่มด้วยบริการ CI/CD ที่ใช้อยู่แล้วเพื่อช่วยตรวจ ทดสอบ และส่งงานไปใช้งาน บริการคลาวด์ที่มีผู้ดูแล แม่แบบโครงการ และคู่มือรับเหตุขัดข้องหรือ runbook ระบุว่าใครแก้แม่แบบ ใครช่วยผู้ใช้ และใครตัดสินใจเมื่อโครงการต้องออกนอกขั้นตอนมาตรฐาน สิ่งเหล่านี้รวมกันเป็นบริการที่ทีมใช้ซ้ำได้ แม้ยังไม่มี portal
CNCF Platform Engineering Maturity Model ยอมรับรูปแบบที่เริ่มจากเอกสารใช้บริการภายนอก และชี้ว่าระดับที่สูงขึ้นใช้เงินกับเวลาคนเพิ่ม จึงไม่ควรไล่ระดับเพื่อให้ชื่อดูสมบูรณ์ สำหรับกรณีนี้ หากแม่แบบกับเอกสารแก้งานซ้ำได้ก่อน ก็ยังไม่มีเหตุผลต้องเพิ่ม Kubernetes หรือแยกทีมเต็มเวลาเพียงเพื่อให้เรียกว่าแพลตฟอร์ม
ต้องมีวิธีรับข้อเสนอและข้อยกเว้นด้วย ถ้าขั้นตอนมาตรฐานใช้งานยากจนทุกโครงการต้องรอคนกลาง ทีมอาจเพียงย้ายคิวงานมาไว้จุดเดียว การมีเจ้าของจึงรวมถึงฟังผู้ใช้ ปรับสิ่งที่ไม่เหมาะ และเลิกดูแลเครื่องมือหรือบริการที่ไม่มีใครใช้
คิดความคุ้มโดยรวมเวลาสร้างและค่าดูแล
สมมติทีมใช้เวลา 120 ชั่วโมงสร้างและทดสอบขั้นตอนที่ทีมใช้ร่วมกันใน 3 เดือนแรก จากนั้นใช้งาน 9 เดือนในปีแรก คาดว่าจะลดงานซ้ำได้รวมทั้งทีม 18 ชั่วโมงต่อเดือน โดยมีงานดูแลส่วนเพิ่ม 8 ชั่วโมงต่อเดือนและค่าบริการเพิ่ม 2,000 บาทต่อเดือนที่ใช้งาน ชั่วโมงทั้งหมดคือเวลารวมที่คนลงมือทำจริง ทั้งเวลาสร้าง งานซ้ำ และงานดูแล ตัวเลขเป็นข้อสมมติ ไม่ใช่ค่าจ้างหรือราคาบริการในตลาด
กำหนดมูลค่าเวลาภายในที่ 800 บาทต่อชั่วโมง เพื่อเทียบมูลค่าเวลาที่ลดงานซ้ำได้กับเวลาและเงินที่ต้องใช้ ไม่เอาเวลารอเครื่องหรือรอคิวทั้งหมดมาคูณเป็นค่าแรง และนับค่าบริการเพิ่มเฉพาะ 9 เดือนหลังเริ่มใช้ตามข้อสมมติ ค่าใช้บริการเดิมที่ไม่เปลี่ยนไม่ได้บวกเป็นต้นทุนเพิ่มซ้ำ
| รายการ | ปีแรก | ปีถัดไป |
|---|---|---|
| เวลาสร้างครั้งแรก | 120 ชั่วโมง | 0 ชั่วโมง |
| เวลาที่ได้คืนจากงานซ้ำ | 18 × 9 = 162 ชั่วโมง | 18 × 12 = 216 ชั่วโมง |
| เวลาดูแลส่วนเพิ่ม | 8 × 9 = 72 ชั่วโมง | 8 × 12 = 96 ชั่วโมง |
| เวลาที่ลดงานซ้ำได้ หักเวลาสร้างและดูแล | −30 ชั่วโมง | +120 ชั่วโมง |
| มูลค่าเวลาที่ได้คืน | 129,600 บาท | 172,800 บาท |
| มูลค่าเวลาสร้างและดูแล | 153,600 บาท | 76,800 บาท |
| ค่าบริการส่วนเพิ่ม | 18,000 บาท | 24,000 บาท |
| มูลค่าเวลาที่ลดได้ หักต้นทุนเวลาสร้าง ดูแล และค่าบริการ | −42,000 บาท | +72,000 บาท |
ปีแรก สร้าง 3 เดือน ใช้ 9 เดือน
−42,000 บาท
เวลาที่ได้คืนยังไม่ชดเชยเวลาสร้าง ดูแล และค่าบริการที่สมมติ
ปีถัดไป ใช้ 12 เดือน
+72,000 บาท
เกิดได้เมื่อใช้ต่อและลดงานซ้ำได้ตามข้อสมมติเดิม
ปีแรกคำนวณเป็น (162 − 120 − 72) × 800 − 18,000 = −42,000 บาท ส่วนปีถัดไปเป็น (216 − 96) × 800 − 24,000 = +72,000 บาท ตัวเลขบวกในปีถัดไปมีเงื่อนไขว่ามีงานให้ใช้เวลาที่ได้คืนจริง ทีมใช้แพลตฟอร์มต่อ และภาระดูแลไม่เกินที่ตั้งไว้ จึงยังเรียกว่าเงินสดประหยัดหรือรายได้เพิ่มไม่ได้
แบบจำลองยังไม่ตีราคาเหตุขัดข้อง ความเสี่ยง ความล่าช้าในการทำฟีเจอร์อื่น หรือความต้องการที่โตขึ้น เวลา 120 ชั่วโมงที่ใช้สร้างถูกนับแล้ว ไม่ควรบวกค่าเสียโอกาสของเวลาเดิมซ้ำ แต่ผลเสียอื่นที่แยกต่างหากต้องนำมาพิจารณาตามหลักฐาน แพลตฟอร์มที่รองรับงานเพิ่มได้มีประโยชน์คนละด้านกับการลดต้นทุนเงินสด ต้องไม่ใช้ผลอย่างหนึ่งแทนอีกอย่าง
เลือกลงทุน ทดลอง หรือรอก่อน
ถ้าทีมเห็นงานซ้ำชนิดเดียวกันหลายครั้ง รู้ว่าทีมใดจะใช้บ้าง และมีคนรับผิดชอบดูแลต่อ ก็นำข้อมูลมากำหนดได้ว่าจะลงทุนทำอะไรบ้าง แต่ถ้ายังไม่รู้ว่าจะลดงานใด การทดลองทำขั้นตอนสำหรับบริการหรือโครงการหนึ่งก่อน จะช่วยให้รู้ว่าต้องแก้อะไร โดยยังไม่ต้องสร้างระบบส่วนกลางขนาดใหญ่
สำหรับการทดลอง ควรจดก่อนว่าผู้ใช้ทำงานอะไร ใช้เวลาลงมือเท่าไร ต้องขอความช่วยเหลือกี่ครั้ง และล้มเหลวตรงไหน แล้วเทียบหลังเริ่มใช้กับงานที่ใกล้เคียงกัน ตรวจด้วยว่าภาระย้ายไปเพิ่มที่ทีมดูแลหรือไม่ ความเร็วที่เพิ่มต้องอ่านคู่กับคุณภาพการเปลี่ยนแปลงและเวลารับมือปัญหา ไม่มีจำนวนคนในทีมที่ใช้เป็นเส้นแบ่งคุ้มทุนได้กับทุกกิจการ
หากยังไม่มีเจ้าของบริการ ยังไม่รู้ว่าจะช่วยลดงานซ้ำส่วนไหน หรือบริการสำเร็จรูปที่ใช้อยู่แก้ปัญหาได้พอ การชะลอสร้างแพลตฟอร์มใหม่มีเหตุผลได้ งานแรกอาจเป็นทำรายชื่อผู้รับผิดชอบ เติมเอกสารที่หาย หรือซ้อมรับเหตุขัดข้อง การรอก่อนควรมีเงื่อนไขว่าจะกลับมาทบทวนเมื่อใด ไม่ใช่ปล่อยให้ปัญหาเดิมไม่มีคนดูแล
ดูว่าทีมทำงานได้เองแค่ไหน และนำเวลาที่ได้คืนไปทำอะไร
อย่านับเพียงจำนวนแม่แบบหรือคนเปิด portal ควรดูว่าผู้ใช้ทำงานสำเร็จได้ด้วยตัวเองหรือไม่ เมื่อผิดพลาดรู้เหตุและแก้ต่อได้หรือไม่ งานดูแลเพิ่มเท่าไร และเวลาที่ได้คืนถูกนำไปทำสิ่งใด ตัวชี้วัดต้องเชื่อมกับปัญหาที่เริ่มแก้ ไม่ใช้จำนวนโค้ดที่ AI สร้างแทนผลการส่งมอบ
ก่อนตั้งโครงการ Platform Engineering ผมอยากให้ทีมเลือกงานที่หลายคนต้องทำซ้ำกันหนึ่งงาน ระบุว่าใครจะใช้ ใครดูแล อยากแก้ปัญหาอะไร และต้องใช้เวลาและเงินดูแลต่อเท่าไร แล้วทดลองใช้เพื่อดูว่างานสะดวกขึ้นจริงหรือไม่ ถ้ายังบอกไม่ได้ว่าจะช่วยงานใด การเพิ่มเครื่องมืออีกชิ้นอาจยังไม่ใช่สิ่งที่ควรทำก่อน
แหล่งอ่านต่อและขอบเขตบทความ
แหล่งหลักที่ลิงก์ไว้ประกอบด้วย CNCF สำหรับแพลตฟอร์มและระดับการพัฒนา DORA สำหรับข้อค้นพบด้านการส่งมอบ Google SRE สำหรับความรับผิดชอบด้านความน่าเชื่อถือ และเอกสาร Backstage กับ GitHub สำหรับตัวอย่างเฉพาะผลิตภัณฑ์ ส่วนทีม SI ขั้นตอนงาน และตัวเลขความคุ้มเป็นกรณีสมมติที่สร้างขึ้นสำหรับบทความนี้ การนำไปใช้ต้องตรวจข้อมูลและเครื่องมือของทีมที่ใช้งานจริง